「商品の需要を予測して、それに基づく生産計画と輸送計画を作り、その実施を通じて在庫量の最適化や生産施設の社員の生活の安定化を図る」…という取り組みは、企業の大規模化が起きた20世紀初めからずっと続く経営課題である。
作り過ぎて在庫になれば管理費用がかかり、廃棄になれば丸ごと損失になる。需要に追い付かなければ売上の機会損失に直結するし、その間に他の企業が顧客を獲得すれば長くシェアを取られるかもしれない。需要に合った生産を、競合他社よりも精度高く安定的に続けられるオペレーションを作り上げることが出来れば、それは一つ大きな競争優位の獲得となる。
優先度は環境により変動するにしても、企業が自由な競争を続ける限り、優れた需要予測・生産計画オペレーションの構築は経営戦略の課題であり続けるだろう。
100年前の課題意識と対応の歴史
文献がまともに残っている数少ない企業と思われるGM(ゼネラルモーターズ、米国の自動車会社)の事例をみると、1924年にGMの財務委員会からアルフレッド・スローン社長宛に出された下記の(過剰生産の責任を問う)質問事項に、この計画に悩んでいた様子がうかがわれる。
- 生産スケジュールはどのような手順をへて作成されたのか。
- 1924年2月25日の段階で「月末の流通在庫はおよそ23万6000台と予想される」としていながら、1924年4月に向けて10万1209台の生産を計画したのは、どのような根拠によるのか。
- 各事業部はなぜ、生産のカットに後れをとったのか。流通在庫の余剰と消費者需要を考え合わせれば、より早い段階で対処が可能だったのではないか。
- 今後、生産量を効果的にコントロールし、過剰生産を避けるために、どのような対策を取るのか。
- 財務委員会は、月例予測が小売販売台数と事業環境全般を考慮しながら作成されているかどうか、判断しなければならない。事業環境に関する情報はどのようなかたちで財務委員会に提供する予定か。
要約すると、「在庫が大量にあることを認識しながら、なぜ全速力で生産して過剰在庫を積み増したのか?誰が何を見て決めた?」という話と、「これからどう直すつもりか?」という話である。
これに対して、スローン社長は「生産スケジュールの決定方法は統一されていなかった」とまず現状を回答したうえで、その原因と今後の対策を打ち返した。
- 原因:自動車業界全体がその慣行を持っており、前例踏襲でそうしていたこと。
- 原因:「ディーラーに納品すれば業績は順調」とみなしてその後の販売に関与しない(=作れる限り生産してディーラーに押し付け、売上計上して後のことは考えない!)社内慣習があったこと。
- 今後の対策:事業部と本社で最終顧客への需要予測を作ることを1924年から全社施策に位置付ける。
- 具体策:1924年からディーラーに依頼して、各事業部に10日ごとに販売データを提出してもらう仕組みを設ける。1924年に集めはじめたデータ項目は、「最終顧客への販売台数」と「新車・中古車の流通在庫量」。
- 具体策:外部の調査機関から定期的に新車登録状況のデータなど需要に関わる統計情報も集める。
つまり、在庫を見て販売傾向と照らし合わせ、生産量を調整する取り組みが、GMでは1924年から本格化したのである。この結果、所得分布と自動車需要の相関関係など、データで可視化できたことも多かったという。この成果は1925年には出た。
”売上げ予測と生産スケジューリングの仕組みを整えたところ、業績が目に見えて改善し、資材・部品の在庫は極限まで抑えられた。1921年には資材、仕掛品、完成品などを含めた在庫回転率は年間およそ2回だったが、1922年には4回となり、1926年には実に7.5回に迫るまでになった。…(中略)…1925年、全米のGMディーラーについて新車の在庫回転率を調べたところ、12回と、それ以前と比べておよそ25%も向上していた。”
※在庫回転率=売れた車の原価 / 平均的に在庫として抱える資材の費用。 これが高いと事業に用いるお金を有効活用できている。
つまり、スローンCEOおよびGMは、サプライチェーンに現れていた問題の解決に成功したのである。
まとめると、100年前のサプライチェーンに起きていた最先端の課題意識とその解決策は、以下のようなものだろう。
- 課題意識=過剰生産の調整がうまく出来ないこと
- 解決策=全社施策の策定と遂行
- 最終顧客の需要に関わるデータを協力会社と連携して収集(10日ごとの販売実績、外部の市場統計レポート)
- 社外も含めた在庫データを協力会社と連携して収集(10日ごとの在庫実績)
- 上記の差分から必要な生産量を分析して生産計画を精緻化
現代の課題意識と対応の打ち手
冒頭に述べた通り、現代でも経営者は精度高く安定的なオペレーションの構築に課題意識を持っている。最近の経営層のインタビュー記事をいくつか読み、日本本社と海外法人のシステムの違いなどを考慮すれば、その課題意識はおそらく、
- 日本と海外で、法人をまたいだサプライチェーンのデータ統合管理が出来ない
- データを統合管理できたとして、これまで通りの費用対効果という観点での最適化はすぐに導き出せるが、新たな成果指標を追求するためのロジックや必要なデータ項目を導き出せない。具体的には下記が成果となる
- 海外の情勢変化に対応できるレジリエントなサプライチェーンにすること
- ESG関連法規に対応できるサプライチェーンにすること
(Environment:環境負荷。CO2排出量など / Society:人権関連の法令対応、○○地域の△△産業では人権侵害が起きているから問題だ…など様々に出てくる / Governance:法令対応。データのうち個人情報の保護をどうするか…など時代と共に増えてくる)
あたりの内容になるのではないだろうか。#1についていえば、おそらく中堅中小企業の海外子会社との連携などをみれば、「10日おきに最新の販売データ・在庫データを世界中から集めて計画策定に使う」だけでも、実現出来ていればかなり優位性のあるオペレーションということになるのではないか。大企業だと#2が主な悩みどころとなっているだろう。
そしてこれらは、#2に関する社内の整理・合意形成には独特の難しさがあるだろうが、そこの整理さえすめば技術的には、非常に容易に解決できる状態になっている。複数システムをまたいでデータ集約を行うことが出来る基盤は既に出ているのだ。最も楽に試せるのは無料版の利用をすすめているDatabricksだろう。(注:私は利害関係は無い)
個人用で操作をするだけならずっと無料である。ログインして画面を見ると、その使いやすさはすぐにわかる。左上に新規追加ボタンがあり、押していくとデータを追加できる画面に到達する。そこには各種クラウドやSaaSが一覧表示され、簡易にデータを取り込めて(Databricksコネクター。画像は一部だけで、国内外の大体のサービスに対応できる)、取り込んだデータは一元管理&集計&図表へ加工できるのだ。しかも生成AIの”Genie”(ChatGPTみたいなもの)と自然言語で話すだけで実現できる。
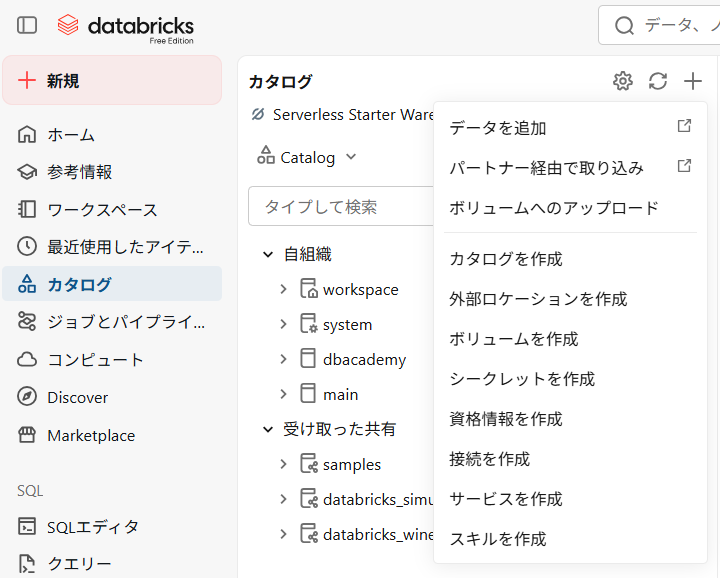
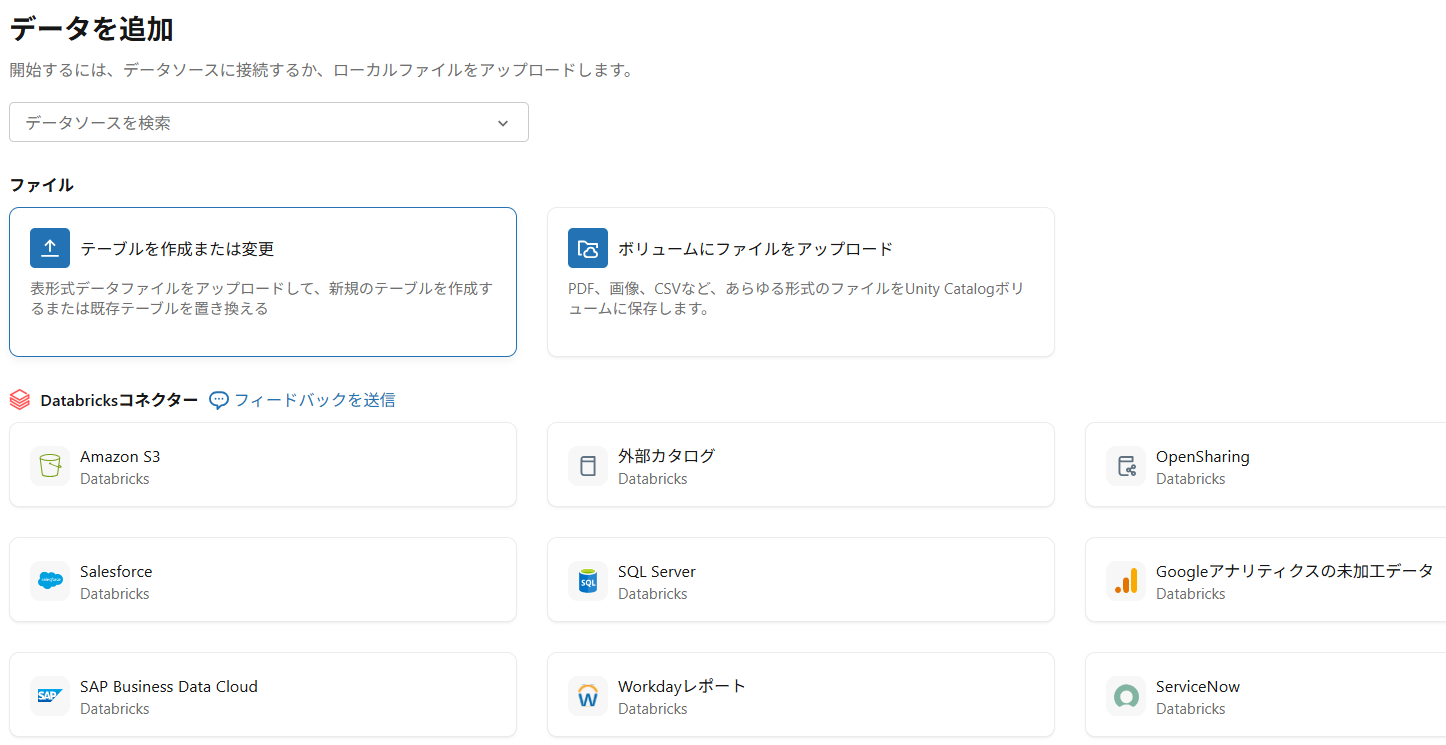
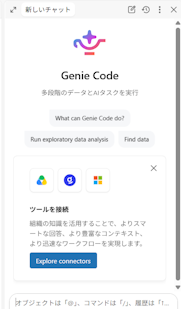
(最後のチャット画面は、常に画面の右端にいるアイコンから呼び出せる)
現代の最先端の課題はやがて、Databricskや似たサービスであるMicrosoft Fabric、Snowflakeによって解消されていくだろう。
もちろんこの解消には技術的な課題だけでなく、海外拠点との協力関係構築や必要であればサプライチェーン上に存在する協力会社と連携することが必要である(例えばAmazon S3からデータを連携するにしても、当然提供元からのAPIキーの連携など協力が要る)。
この連携を進めるうえで、大企業から中堅中小企業にいたるまで、(技術的には簡単な話で目的も長らく目指されてきたシンプルな話なので)自力で進めることがまずは望ましいように思うが、必要に応じて大企業ならコンサル、中堅中小企業ならPEファンドといった外部支援会社を活用することもあるかもしれない。
サプライチェーンの連携がますます広範囲&データ項目も豊富になり、効果的な運営をもたらせるようになれば、社会全体にとっても有益な話だと思う。